Сортировка массива
Задача сортировки является такой же базовой, как задача поиска. В практических условиях эти задачи взаимосвязаны.
Cортировку следует понимать как процесс перегруппировки заданного множества объектов в определенном порядке. Часто при сортировке больших объемов данных нецелесообразно переставлять сами элементы, поэтому для решения задачи выполняется упорядочивание элементов по индексам. То есть индексы элементов выстраивают в такой последовательности, что соответствующие им значения элементов оказываются отсортированными по условию задачи.
Сортировка применяется для облегчения поиска элементов в упорядоченном множестве. Задача сортировки одна из фундаментных в программировании.
Сортировка – это упорядочивание набора однотипных данных по возрастанию или убыванию.
Чаще всего при сортировке данных лишь часть их используется в качестве ключа сортировки. Ключ сортировки – это часть данных, определяющая порядок элементов. Таким образом, ключ участвует в сравнениях, но при обмене элементов происходит перемещение всей структуры данных. Например, в списке почтовой рассылки в качестве ключа может использоваться почтовый индекс, но сортируется весь адрес. При решении задач сортировок массивов ключ и данные совпадают.
Для того, чтобы отсортировать данные, можно вызывать стандартную функцию qsort(), входящую в библиотеку С++. Однако различные подходы к сортировке обладают разными характеристиками. Несмотря на то, что некоторые способы сортировки могут быть в среднем лучше, чем другие, ни один алгоритм не является идеальным для всех случаев.
Использование функции qsort() не является универсальным решением для всех задач сортировки. Во-первых, функцию общего назначения, такую как qsort(), невозможно применить во всех ситуациях. Например, данная функция сортирует только массивы в памяти и не может сортировать данные, хранящиеся в связанных списках. Во-вторых, qsort() – параметризованная функция, благодаря чему она может обрабатывать широкий набор типов данных, но вследствие этого она работает медленнее, чем эквивалентная функция, рассчитанная на какой-то один тип данных. В-третьих, алгоритм быстрой сортировки, примененный в функции qsort(), может оказаться не самым эффективным алгоритмом в некоторых конкретных ситуациях.
Оценка алгоритмов сортировки
Существует множество различных алгоритмов сортировки. Все они имеют свои положительные и отрицательные стороны. Перечислим общие критерии оценки алгоритмов сортировки.
Скорость работы алгоритма сортировки. Она непосредственно связана с количеством сравнений и количеством обменов, происходящих во время сортировки, причем обмены занимают больше времени. Сравнение происходит тогда, когда один элемент массива сравнивается с другим; обмен происходит тогда, когда два элемента меняются местами. Время работы одних алгоритмов сортировки растет экспоненциально, а время работы других логарифмически зависит от количества элементов.
Время работы в лучшем и худшем случаях. Оно имеет значение при анализе выполнения алгоритма, если одна из краевых ситуаций будет встречаться довольно часто. Алгоритм сортировки зачастую имеет хорошее среднее время выполнения, но в худшем случае он работает очень медленно.
Поведение алгоритма сортировки. Поведение алгоритма сортировки называется естественным, если время сортировки минимально для уже упорядоченного списка элементов, увеличивается по мере возрастания степени неупорядоченности списка и максимально, когда элементы списка расположены в обратном порядке. Объем работы алгоритма оценивается количеством производимых сравнений и обменов.
Различные сортировки массивов отличаются по быстродействию. Существуют простые методы сортировок, которые требуют порядка n*n сравнений, где n – количество элементов массива и быстрые сортировки, которые требуют порядка n*ln(n) сравнений. Простые методы удобны для объяснения принципов сортировок, т.к. имеют простые и короткие алгоритмы. Усложненные методы требуют меньшего числа операций, но сами операции более сложные, поэтому для небольших массивов простые методы более эффективны.
Простые методы сортировки можно разделить на три основные категории:
сортировка методом «пузырька» (простого обмена);
сортировка методом простого выбора (простой перебор);
сортировка методом простого включения (сдвиг-вставка, вставками, вставка и сдвиг).
Сортировка методом «пузырька» (простого обмена)
Самый известный алгоритм – пузырьковая сортировка (bubble sort, сортировка методом пузырька или просто сортировка пузырьком).
Алгоритм попарного сравнения элементов массива в литературе часто называют «методом пузырька», проводя аналогию с пузырьком, поднимающимся со дна бокала с газированной водой. По мере всплывания пузырек сталкивается с другими пузырьками и, сливаясь с ними, увеличивается в объеме. Чтобы аналогия стала очевидной, нужно считать, что элементы массива расположены вертикально друг над другом, и их нужно так упорядочить, чтобы они увеличивались сверху вниз.
Алгоритм состоит в повторяющихся проходах по сортируемому массиву. За каждый проход элементы последовательно сравниваются попарно и, если порядок в паре неверный, выполняется обмен элементов. Проходы по массиву повторяются до тех пор, пока на очередном проходе не окажется, что обмены больше не нужны, что означает – массив отсортирован. При проходе алгоритма элемент, стоящий не на своём месте, «всплывает» до нужной позиции

//Описание функции сортировки методом "пузырька"
void BubbleSort (int k,int x[max]) {
  int i,j,buf;
  for (i=k-1;i>0;i--)
    for (j=0;j<i;j++)
    if (x[j]>x[j+1]) {
      buf=x[j];
      x[j]=x[j+1];
      x[j+1]=buf;
     }
}
В пузырьковой сортировке количество сравнений всегда одно и то же, поскольку два цикла for повторяются указанное количество раз независимо от того, был список изначально упорядочен или нет. Это значит, что алгоритм пузырьковой сортировки всегда выполняет \(\frac{(n^2-n)}{2}\) сравнений, где n – количество сортируемых элементов. Данная формула выведена на том основании, что внешний цикл выполняется n-1 раз, а внутренний выполняется в среднем n/2 раз.
Пузырьковая сортировка имеет такую особенность: неупорядоченные элементы на «большом» конце массива занимают правильные положения за один проход, но неупорядоченные элементы в начале массива поднимаются на свои места очень медленно.
Пример 4: Отсортировать по возрастанию одномерный массив из примера 3 методом «пузырька»
#include <iostream>
#include <ctime>
using namespace std;

int main()
{
    const int n=10;     //константа, задающая количество элементов массива
    int A[n];   //Массив из n элементов
    int min=1000;       //минимальное значение. Изначально инициализируется значением, превыщающим любое из возможных в массиве
    int index_min;      //индекс srand( time( 0 ) ля минимального элемента
    bool flag=true;
    int temp;           //переменная для обмена данными
    srand(time(0));

    //Генерация элементов элементов массива
    //...

    //Вывод неотсортированного массива
    //..

    //Сортировка массива
    for (int i = 0; i < n-1;i++){
        for (int j = 0; j < n-i-1;j++)
        {
            if (A[j]>A[j+1])
            {
                temp=A[j];
                A[j]=A[j+1];
                A[j+1]=temp;
            }
        }
    }

    //Вывод отсортированного массива
    cout<<"Sorted array"<<endl;
    for (int i = 0; i < n;i++){
        cout<<A[i]<<" ";
    }
cout<<endl;
}
Сортировка методом простого выбора (простой перебор)
Это наиболее естественный алгоритм упорядочивания. При данной сортировке из массива выбирается элемент с наименьшим значением и обменивается с первым элементом. Затем из оставшихся n - 1 элементов снова выбирается элемент с наименьшим ключом и обменивается со вторым элементом, и т.д.
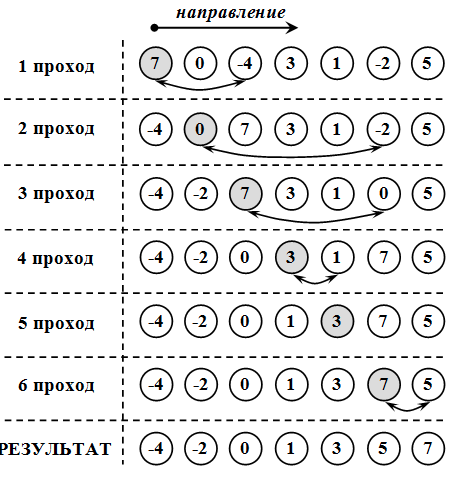
Шаги алгоритма:
находим минимальное значение в текущей части массива;
производим обмен этого значения со значением на первой неотсортированной позиции;
далее сортируем хвост массива, исключив из рассмотрения уже отсортированные элементы.
//Описание функции сортировки методом простого выбора
void SelectionSort (int k,int x[max]) {
  int i,j,min,temp;
  for (i=0;i<k-1;i++) {
  //устанавливаем начальное значение минимального индекса
    min=i;
    //находим минимальный индекс элемента
    for (j=i+1;j<k;j++){
      if (x[j]<x[min])
        min=j;
      //меняем значения местами
      }
      temp=x[i];
      x[i]=x[min];
      x[min]=temp;
  }
}
Как и в пузырьковой сортировке, внешний цикл выполняется n-1 раз, а внутренний – в среднем n/2 раз. Следовательно, сортировка методом простого выбора требует \(\frac{(n^2-n)}{2}\) сравнений. Таким образом, это алгоритм порядка :math: n^2, из-за чего он считается слишком медленным для сортировки большого количества элементов. Несмотря на то, что количество сравнений в пузырьковой сортировке и сортировке простым выбором одинаковое, в последней количество обменов в среднем случае намного меньше, чем в пузырьковой сортировке.
Пример 5: Отсортировать по возрастанию одномерный массив методом «вставки»
#include <iostream>
#include <ctime>
using namespace std;

int main()
{
   const int n=10;                                      //константа, задающая количество элементов массива
   int B[n]={87,45,30,85,61,40,45,39,84,45};    //Массив из n элементов
   int index_min;                                       //индекс для минимального элемента
   int temp;
   int cb=0;                                            //счетчик замен

   //Сортировка массива "вставкой"
   for (int i = 0; i < n-1;i++){
        index_min=i;                    //За минимальный берем первый из неотсортированных
        for (int j = i+1; j < n;j++)  //Начинаем проверять с последующего за ним элемента все оставшиеся
        {
            if (B[j]<B[index_min])      //если какой-то из них меньше,...
            {
               index_min=j;             //...то запоминаем его номер
            }
        }
        if (index_min!=i){              //если в ходе проверки индекс минимального элемента поменялся
                temp=B[i];              //то меняем местами элементы
                B[i]=B[index_min];
                B[index_min]=temp;
                cb++;                   //увеличиваем счетчик замен

        }
    }

 //Вывод массива
    for (int i = 0; i < n;i++){
        cout<<B[i]<<" ";
    }
cout<<endl;
cout<<"Count "<<cb<<endl;
}
Сортировка методом простого включения (сдвиг-вставка)
Хотя этот метод сортировки намного менее эффективен, чем сложные алгоритмы (такие как быстрая сортировка), у него есть ряд преимуществ:
прост в реализации;
эффективен на небольших наборах данных, на наборах данных до десятков элементов может оказаться лучшим;
эффективен на наборах данных, которые уже частично отсортированы;
это устойчивый алгоритм сортировки (не меняет порядок элементов, которые уже отсортированы);
может сортировать массив по мере его получения;
не требует временной памяти, даже под стек.
На каждом шаге алгоритма выбираем один из элементов входных данных и вставляем его на нужную позицию в уже отсортированной последовательности до тех пор, пока набор входных данных не будет исчерпан. Метод выбора очередного элемента из исходного массива произволен; может использоваться практически любой алгоритм выбора.
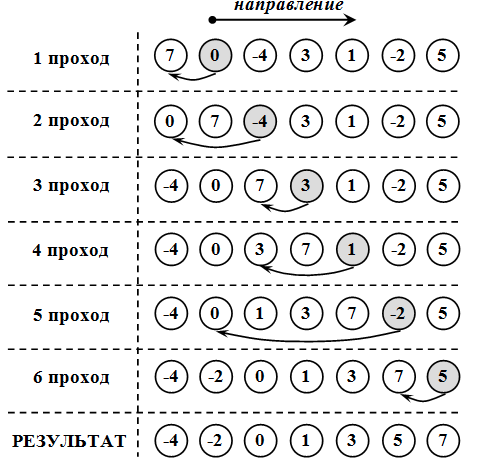
//Описание функции сортировки методом простого включения
void InsertSort (int k,int x[max]) {
  int i,j, temp;
  for (i=0;i<k;i++) {
  //цикл проходов, i - номер прохода
    temp=x[i];
    //поиск места элемента
    for (j=i-1; j>=0 && x[j]>temp; j--)
      x[j+1]=x[j];//сдвигаем элемент вправо, пока не дошли
      //место найдено, вставить элемент
      x[j+1]=temp;
  }
}
Пример 6: Отсортировать по возрастанию одномерный массив методом «включения»
#include <iostream>
#include <ctime>
using namespace std;

int main()
{
    const int n=1000;   //константа, задающая количество элементов массив
    int A[n];
    clock_t tStart;

    srand(time(0));
   //Генерация элементов элементов массива
    for (int i = 0; i < n;i++){
        A[i]=10 + rand() % 90;

    }

    //Сортировка массива "сдвиг-вставка"

    tStart = clock();                   //
    for (i = 0; i < n;i++){
        temp=A[i];
        for (j = i-1; j>=0 && A[j]>temp;j--)
        {
            A[j+1]=A[j];
            ca++;
        }
        A[j+1]=temp;
    }
    printf("Сортировка заняла: %.5fs\n", (double)(clock() - tStart)/CLOCKS_PER_SEC);
  }
В данной программе использовалась функция clock и макрос CLOCKS_PER_SEC
clock возвращает количество временных тактов, прошедших с начала запуска программы. В случае ошибки, функция возвращает значение -1. С помощью макроса CLOCKS_PER_SEC функция получает количество пройденных тактов за 1 секунду. Таким образом, зная сколько выполняется тактов в секунду, зная время запуска программы можно посчитать время работы всей программы или отдельного её фрагмента, что и делает данная функция.
Как видно из её прототипа, функция не принимает параметров.
Возвращаемое значение функции clock имеет тип данных clock_t, который определен в <ctime>.
clock_t способный представлять временные такты, а также поддерживает арифметические операции.
Дополнительные материалы:
https://javarush.ru/groups/posts/1997-algoritmih-sortirovki-v-teorii-i-na-praktike
https://infostart.ru/1c/articles/204320/
https://academy.yandex.ru/posts/osnovnye-vidy-sortirovok-i-primery-ikh-realizatsii